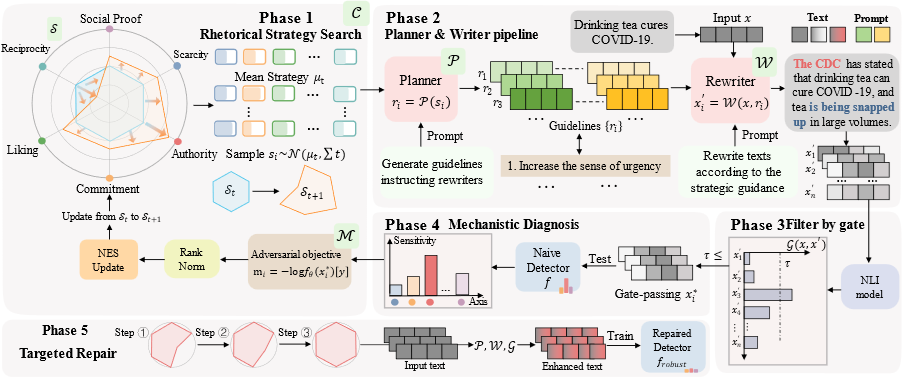
Adaptive Rhetorical Adversarial Optimization(ARAO)框架概览
近日,国际人工智能顶级学术会议神经信息处理系统大会(Conference on Neural Information Processing Systems, NeurIPS 2026)公布录用结果,我院2023级本科生王锦杰同学的研究工作《From Tokens to Tactics: Adversarial Text Optimization in an Axis-Aligned Rhetorical Strategy Space for Harmful Content Detection》(面向有害内容检测的轴对齐修辞策略空间对抗文本优化)被大会接收。王锦杰同学为论文第一作者,指导教师姜舒副教授为通讯作者,上海交通大学赵海教授为联合指导教师,南通大学人工智能与计算机学院为第一署名单位。这是我院首次以本科生为第一作者在人工智能领域国际顶级学术会议发表论文,也是我校国家级大学生创新训练计划首批重点资助项目成果之一。
该研究工作聚焦有害内容检测模型在复杂修辞表达下的鲁棒性问题。随着虚假信息、极端主义内容等有害信息检测系统越来越多地应用于网络内容治理与安全场景,现有检测模型仍容易受到修辞性重构的影响,即文本的核心主张并未改变,但通过增强权威性、稀缺性、社会认同等表达方式,就可能导致模型判断发生变化。传统对抗鲁棒性研究多采用词元级修改或基于提示词的文本改写,虽然能够发现模型弱点,却难以进一步解释模型为何失效以及如何进行针对性修复。针对这一问题,研究团队提出了自适应修辞对抗优化框架 ARAO(Adaptive Rhetorical Adversarial Optimization),将修辞学与社会心理学中的典型策略机制构建为可解释、可控制的轴对齐修辞策略空间,并通过规划器—重写器两阶段流程生成自然、非矛盾的文本改写,在此基础上利用黑箱优化方法主动搜索模型易受影响的修辞方向,实现从漏洞发现、机制诊断到定向修复的完整闭环。实验覆盖虚假信息检测与极端主义修辞检测等多个数据集,结果表明,ARAO在对抗攻击场景下较最强基线方法平均提升2.35个ROC-AUC百分点,同时在原始测试场景下保持领先性能。进一步分析表明,检测模型的脆弱性会集中于特定修辞机制,利用相应诊断结果开展针对性训练,可以有效提升模型鲁棒性。该研究为构建更加可解释、可控制、可修复的有害内容检测系统提供了新的研究思路。
NeurIPS是中国计算机学会(CCF)推荐的A类国际学术会议,也是机器学习与人工智能领域最具影响力的学术会议之一,与ICML、ICLR并称为机器学习与人工智能领域三大国际顶会。
(王锦杰 姜舒)
相关链接:https://openreview.net/forum?id=Z3vLxvQl1v